虚拟化平台出现多台虚拟机持续卡顿、业务响应明显变慢。相关物理网卡始终保持 Link Up、10Gbps、全双工状态,未出现明显掉线。排查结果表明,异常与 vSAN 主用物理链路持续产生大量接收帧错误有关。隔离异常链路并将流量切换到备用链路后,vSAN 与虚拟机恢复正常。
本文按照实际排查顺序,对虚拟机 I/O、vSAN 健康检查、网络路径和物理网卡计数进行关联分析。虚拟机卡顿只是表面现象,只有将不同层级的性能数据和日志证据放在一起,才能逐步缩小故障范围,最终定位到异常链路。
1 、虚拟机延迟确认
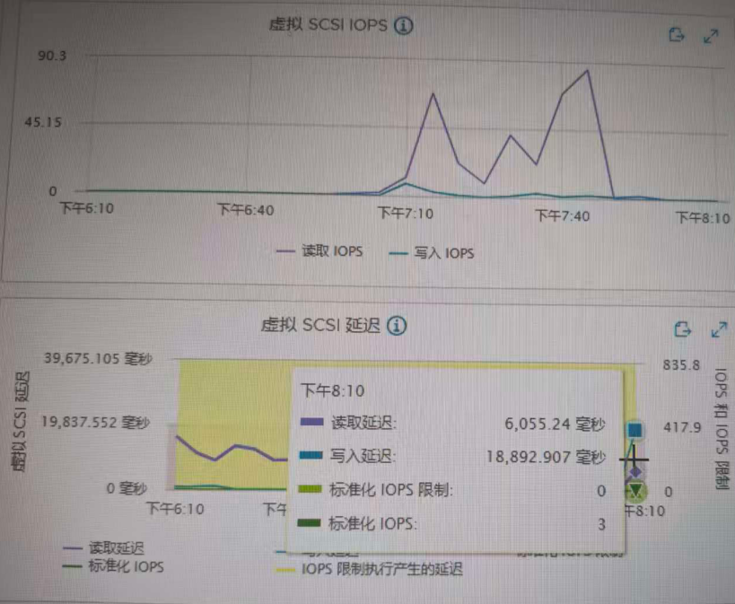
先检查虚拟机的虚拟 SCSI延迟。在一次异常采样中,读取延迟为 6,055.24 ms,写入延迟达到 18,892.907 ms,相当于一次读取等待约 6 秒、一次写入接近 19 秒。该延迟足以造成虚拟机明显卡顿,与现场表现一致。
同一组性能图中,读取延迟 0.503 ms,写入延迟 1,877.095 ms。
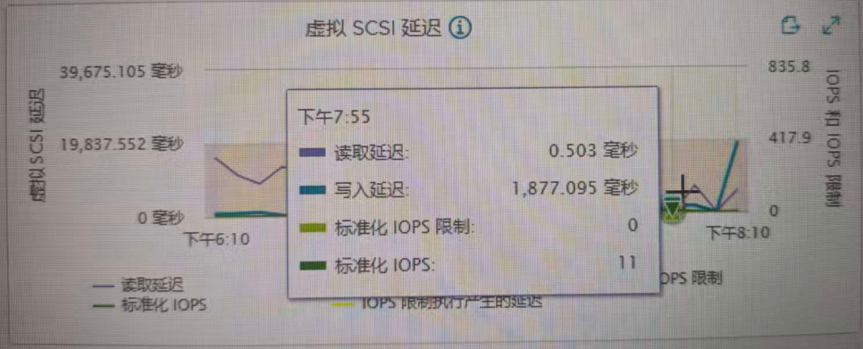
异常期间的 IOPS 并不高,但较低的 I/O 数量不能说明存储访问正常。虚拟 SCSI 延迟已达到秒级,需要继续确认等待发生在虚拟机内部、vSAN 存储服务还是跨主机网络路径。
2、vSAN I/O 路径定位
红色告警指向 ESXi-B 的 vSAN 网络路径,主机名称已匿名化。
确认虚拟机存在明显 I/O 等待后,继续使用 I/O 行程分析器检查访问路径。结果显示,红色告警位于计算节点 ESXi-A 与远程组件节点 ESXi-B 之间,异常指向跨主机的 vSAN 网络路径。
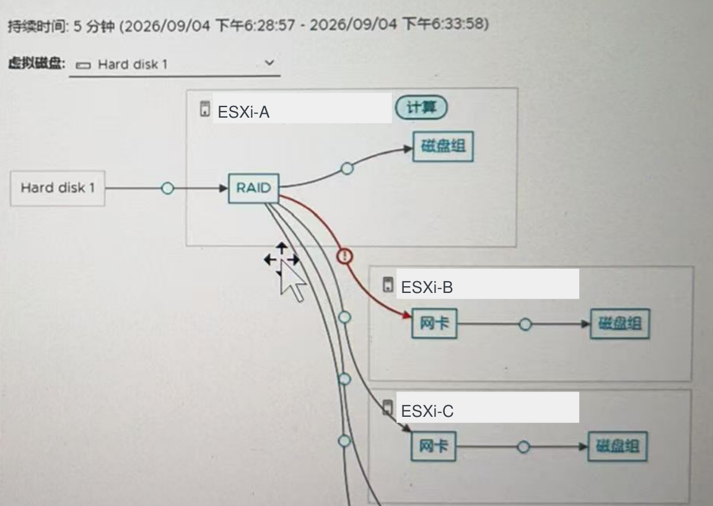
该虚拟机并不运行在 ESXi-B 上,但其部分 vSAN 组件位于 ESXi-B。排查 vSAN 性能问题时,不能只检查虚拟机所在主机,还需要确认数据实际经过的组件节点和网络路径。
检查vSAN 网络延迟详情。两组组件平均写入延迟分别为 284 ms 和 197.3 ms,其中一组标准偏差为 228.65 ms。
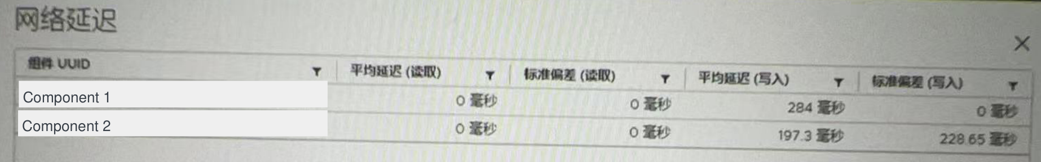
上述数值是 I/O 行程分析记录的网络延迟,并非所有虚拟机的平均磁盘延迟。结合红色路径告警,异常范围已收敛到 vSAN 网络方向,后续检查继续沿该路径展开。
3、vSAN 网络异常证据
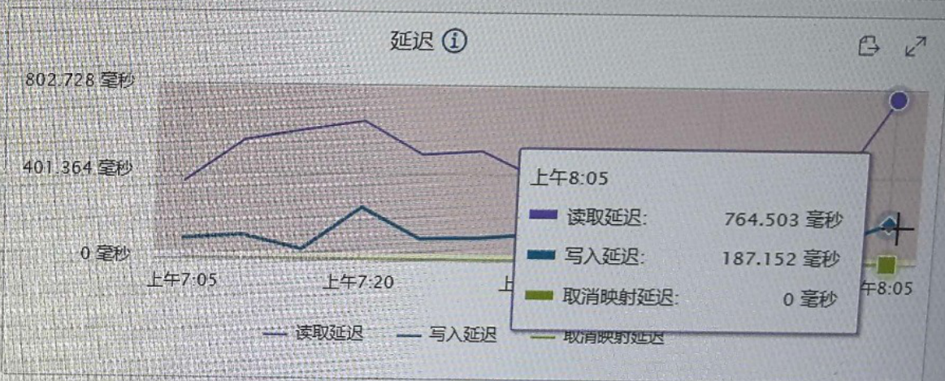
ESXi-B 的 vSAN 性能视图显示,读取延迟为 764.503 ms,写入延迟为 187.152 ms。
ESXi-B 的 vSAN 性能延迟视图节选,读写延迟均达到数百毫秒。
通过Skyline 运行状况检查同时报出异常。多条与 ESXi-B 有关的 vSAN 大包 Ping 路径显示红色或黄色,异常目标均指向 vmk3。
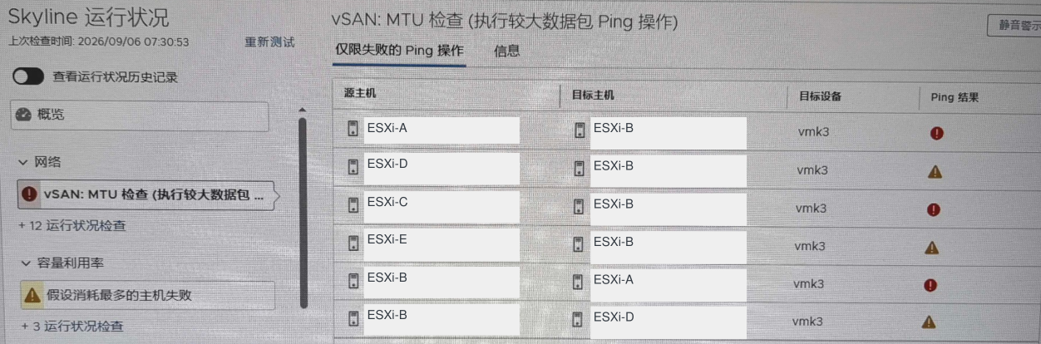
进一步核对 vmk3、虚拟交换机和物理上联的映射关系。大包 Ping 失败可能由端到端 MTU 不一致引起,也可能与丢包或物理链路质量劣化有关。仅凭检查项名称不能直接判定需要修改 MTU。
4 、健康检查与迁移异常
vSAN 运行状况历史中,红色、黄色和绿色状态交替出现,说明异常具有间歇性。历史记录显示,多条经过 ESXi-B 的 vmk3 路径出现同类异常。
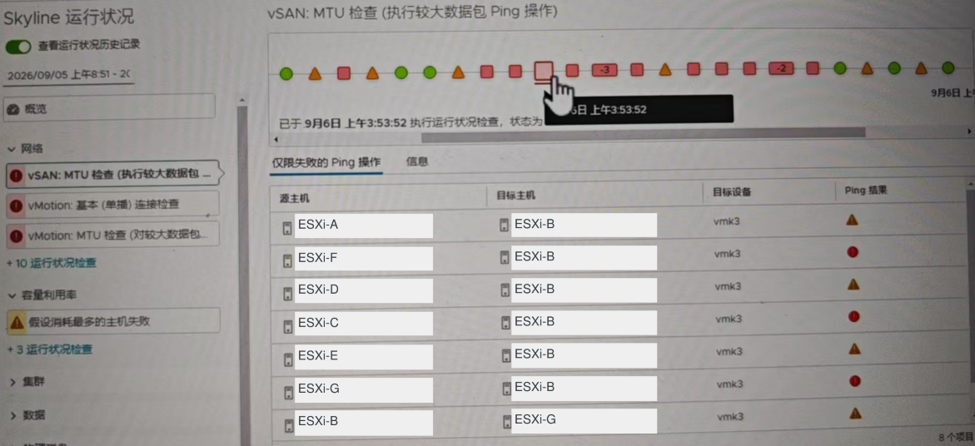
相关记录中还出现 vMotion 失败:目标主机未收到源主机通过 vMotion 网络发送的数据,随后发生等待迁移启动请求超时。

vMotion 失败说明主机之间出现过通信异常。但 vMotion 与 vSAN 属于不同业务流,是否共用物理上联,还需要核对各自的 VMkernel、VLAN 和上联映射。因此,该记录只能作为辅助证据,不能单独证明 vmnic1 存在故障。
5、物理网卡计数定位
沿 ESXi-B 的 vSAN 路径继续检查,确认 vmk3 的主用 uplink3 对应 vmnic1,备用 uplink4 对应 vmnic2。该映射来自支持包中的 vSAN 网络和分布式交换机配置。
link selection = link state up active= uplink3-> vmnic1 standby = uplink4-> vmnic2
支持包中的 commands/nicinfo.sh.txt 显示,vmnic1 虽保持 Up、10Gbps、全双工状态,但FCS 错误帧已超过 1,400 万,编码错误帧超过 155 万。关键字段如下。
vmnic1 Driver: bnxtnetAdmin Status: Up Link Status: UpSpeed: 10000 Mbps Duplex: Fullrx_stat_err: 14178327 rx_fcs_err_frames: 14176251 rx_code_err_frames:1553891 rx_link_down_events: 1
采集字段 | vmnic1 主用 | vmnic2 备用 |
Link Status / Speed | Up / 10Gbps | Up / 10Gbps |
rx_stat_err | 14,178,327 | 0 |
rx_fcs_err_frames | 14,176,251 | 0 |
rx_code_err_frames | 1,553,891 | 0 |
rx_link_down_events | 1 | 0 |
上述数值为支持包采集时的累计计数。备用 vmnic2 的同类计数均为 0,两条链路形成了明确对照,具备进一步切流验证的条件。
FCS 是以太网帧的校验值。接收端检测到校验失败后会丢弃错误帧;vSAN 使用 TCP 通信,丢包可能触发重传并增加 I/O 等待。因此,Link Up 只能说明链路已经建立,不能证明链路传输质量正常。Broadcom KB 341594 和 KB 326609 对相关计数和影响有进一步说明。
综合以上证据,故障范围已从虚拟机性能异常收敛到 vmnic1 所在的物理接收链路。
6、异常链路隔离与业务恢复
vmnic1 始终保持 Link Up,主备策略继续将其判定为可用上联,因此备用 vmnic2 未自动接管。确认备用路径可用后,手工将 vmnic1 置为 DOWN,vSAN 流量随即按既有策略切换到 vmnic2。
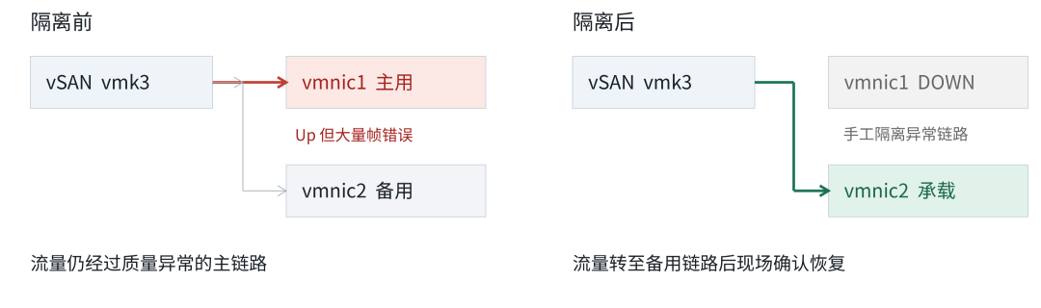
链路切换完成后,vSAN 状态和虚拟机响应恢复正常。路径告警、网卡错误计数与切流后的恢复结果能够相互印证,vmnic1 所在物理链路被判定为本次性能故障的主要原因。
现有证据能够将异常定位到 vmnic1 所在物理链路,但尚不能唯一确定具体故障部件。后续仍需检查服务器网卡端口、光模块、光纤或线缆以及交换机端口。
虚拟机心跳日志的辅助证据
hostd 日志还记录了多台虚拟机的心跳降级。以下摘录关键字段,虚拟机名称已匿名化。
VM-01 heartbeat red,actual=1/30 VM-02 heartbeat red,actual=10/30 VM-03 heartbeat yellow, actual=20/30 VM-04 heartbeat yellow, actual=30/38
虚拟机心跳降级反映其响应能力下降,但不能单独证明 vSAN 网络异常。将该记录与 I/O 路径告警、vSAN 延迟和物理网卡错误计数结合分析,可作为影响范围的辅助证据。
同一份支持包中,节点状态仍显示 HEALTHY。该状态只能说明采集时健康检查未判定节点退出或失效,不能代表所有性能指标正常。健康状态与实际响应速度需要分别判断。
7、 可复用的排查方法
先选择一台受影响的虚拟机确认 I/O 延迟,再沿 I/O 路径判断异常发生在哪个层级。发现跨主机的 vSAN 网络告警后,继续核对 VMkernel、上联映射和物理网卡计数,可以逐步缩小故障范围。
累计计数只能说明网卡曾经出现过错误,连续采样的增量才能判断错误是否仍在增长。采集数据时应同时记录计数、流量负载和交换机端口状态,便于两端对照。
影响范围不能只根据虚拟机所在主机判断。vSAN 组件分布在不同节点,虚拟机可能通过网络访问远程组件,本次 I/O 路径即属于这种情况。
业务恢复后,异常链路应继续保持隔离。后续维护窗口需检查交换机端口错误、两端光模块状态和光功率,并依次替换光纤、光模块或端口。每次只改变一个变量,操作前后记录错误计数和延迟,才能进一步确认具体故障部件。
原链路修复并重新承载流量后,应在实际业务负载下持续观察网卡错误计数、vSAN 网络延迟、虚拟机磁盘延迟和业务响应。空闲状态下 Ping 正常或错误计数暂未增长,不能作为完整的验收依据。
现场信息采集建议
以下命令均为只读检查。网卡编号应按照现场映射进行替换;FCS 和编码错误等驱动计数,可以结合支持包中的 nicinfo.sh.txt 进行核对。
esxcli vsan network list esxcli network nic list esxcli network nic stats get -n vmnic1 esxcli network nic stats get -n vmnic2
本次能够直接隔离 vmnic1,前提是故障路径已经核实且备用链路确认可以接管。执行类似操作前,应确认备用链路的连通性和容量,核查目标网卡是否承载其他业务,并准备恢复方案。
本次故障的关键特征是物理网卡始终保持 Link Up,但链路质量已经明显劣化。遇到虚拟机未宕机却持续卡顿的情况,除检查链路状态外,还应继续核对 Error、FCS、编码错误和延迟等指标。
评论